Biblio
Мультимодальный искусственный интеллект обрабатывает одновременно несколько типов данных: текст, изображения, голос, видео. Библиотеки используют эту технологию для помощи слабовидящим читателям, автоматического описания иллюстраций, голосового поиска по каталогу, распознавания рукописей. В 2026 году мультимодальные модели стали доступны даже небольшим библиотекам — через API крупных провайдеров или open-source решения. Разберём, как устроен мультимодальный ИИ, какие задачи он решает в библиотеке и как внедрить технологию на практике. Обзор AI-инструментов для библиотек — в статье «Инструменты ИИ в библиотеке: обзор систем и решений».
Оглавление
- Что такое мультимодальный ИИ
- Как работает мультимодальная модель
- Задачи мультимодального ИИ в библиотеке
- Мультимодальный ИИ для инклюзии
- Автоматическое описание иллюстраций и обложек
- Голосовой и визуальный поиск по каталогу
- Обработка оцифрованных архивов
- Какие модели использовать
- Как внедрить мультимодальный ИИ
- Частые вопросы
Что такое мультимодальный ИИ
Мультимодальный ИИ — это система, которая понимает и обрабатывает разные типы данных одновременно: текст, изображения, аудио, видео. Обычная языковая модель читает только текст. Мультимодальная модель видит картинку, слышит речь, читает текст и связывает всё это в единое понимание.
Пример: читатель фотографирует обложку книги на полке и спрашивает голосом: «Что это за книга?». Мультимодальная система распознаёт изображение обложки, читает название автора, ищет книгу в каталоге и отвечает голосом: «Это роман Льва Толстого „Анна Каренина», издание 1995 года, находится в отделе художественной литературы».
Какие модальности объединяет ИИ
- Текст: описания, вопросы, инструкции, документы
- Изображения: фотографии, иллюстрации, обложки, страницы книг
- Голос: вопросы читателей, надиктовка текста, аудиоинструкции
- Видео: записи лекций, мастер-классов, экскурсий по библиотеке
Система переводит каждую модальность в общее числовое представление, которое модель понимает. Текст, картинка, звук становятся точками в одном пространстве значений. Модель находит связи между ними и генерирует ответ в нужной форме: текстом, описанием изображения, синтезированной речью.
Как работает мультимодальная модель
Vision-Language модели
Vision-Language модели (VLM) объединяют компьютерное зрение и обработку языка. Модель принимает изображение и текстовый запрос, анализирует картинку и отвечает текстом.
Как это работает:
- Изображение разбивается на фрагменты (патчи), каждый кодируется в числовой вектор
- Текстовый запрос также кодируется в векторы
- Модель сопоставляет векторы изображения и текста, находит соответствия
- Генерирует текстовый ответ на основе понимания картинки
Примеры задач для VLM:
- Описание иллюстрации в книге для незрячих читателей
- Поиск книги по фотографии обложки
- Распознавание рукописного текста на сканах архивных документов
- Анализ состояния редкой книги по фотографии (повреждения, износ)
Голосовой интерфейс
Голосовой интерфейс состоит из двух частей: распознавание речи (Speech-to-Text) и синтез речи (Text-to-Speech).
Speech-to-Text (STT): преобразует голос читателя в текст. Модель распознаёт слова, учитывает контекст, расставляет знаки препинания. Современные STT-модели понимают акценты, работают с несколькими языками одновременно, распознают речь в шуме.
Text-to-Speech (TTS): превращает текстовый ответ системы в речь. Модель озвучивает текст с интонацией, паузами, ударениями. Качественный TTS звучит почти как живой человек.
Сценарий: читатель задаёт вопрос голосом: «Где найти книги по истории России?». STT-модель распознаёт вопрос в текст, система находит ответ в базе знаний, TTS-модель озвучивает ответ: «Книги по истории России находятся на втором этаже, стеллажи с 12 по 18, раздел 63.3(2)».
Объединение модальностей
Мультимодальная система объединяет vision, language и audio в единый интерфейс. Читатель может задать вопрос голосом и получить ответ с изображениями, показать фото и получить текстовое описание, надиктовать заметку и увидеть её в виде структурированного текста.
Пример связки модальностей: читатель фотографирует старую газету с плохо читаемым текстом и спрашивает голосом: «Что тут написано?». Система распознаёт речь (STT), анализирует фото (vision), извлекает текст (OCR), отвечает голосом (TTS): «Это статья из газеты „Правда» от 15 мая 1945 года, заголовок — „Победа»».
Задачи мультимодального ИИ в библиотеке
| Задача | Какие модальности | Пример использования |
|---|---|---|
| Описание иллюстраций | Изображение → Текст | Автоматическое создание alt-текста для иллюстраций в электронных книгах |
| Голосовой поиск | Голос → Текст → Поиск → Голос | Читатель спрашивает голосом, где найти книгу, система отвечает голосом |
| Визуальный поиск | Изображение → Поиск | Читатель фотографирует обложку, система находит книгу в каталоге |
| Распознавание рукописей | Изображение → Текст | Оцифровка архивных документов с рукописным текстом |
| Озвучка текста | Текст → Голос | Аудиокниги для слабовидящих читателей |
| Субтитры к видео | Видео → Текст | Автоматические субтитры к записям лекций и мастер-классов |
| Ответы на вопросы по изображению | Изображение + Текст → Текст | Читатель показывает карту и спрашивает: «Где находится этот город?» |
Мультимодальный ИИ для инклюзии
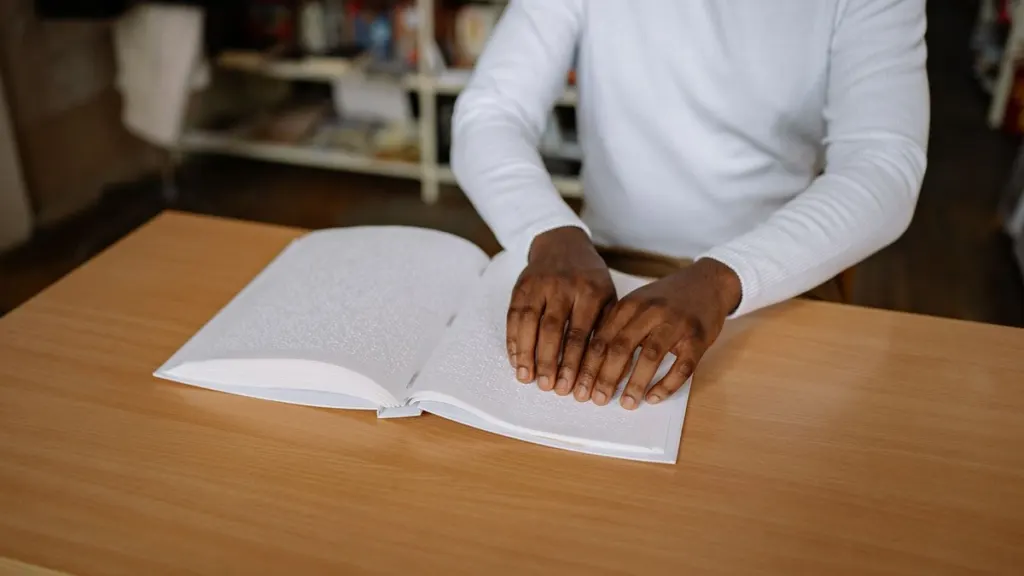
Мультимодальный ИИ делает библиотечные сервисы доступными для людей с нарушениями зрения, слуха, моторики. Технология адаптирует контент под разные способы восприятия: текст превращается в голос, изображения — в описания, голос — в текст с субтитрами.
Помощь незрячим и слабовидящим читателям
Описание иллюстраций: Vision-Language модель описывает иллюстрации в книгах, схемы, графики, карты. Читатель запрашивает описание через скринридер, система генерирует подробный текст: «На иллюстрации изображён мужчина в синем пиджаке, стоящий у окна. За окном видны деревья и небо. Слева от него стол с раскрытой книгой».
Распознавание объектов в реальном времени: мобильное приложение библиотеки использует камеру телефона для распознавания книг на полке. Читатель наводит камеру на полку, ИИ распознаёт названия книг и зачитывает их вслух. Это помогает ориентироваться в библиотеке без помощи сотрудника.
Навигация по зданию: система с компьютерным зрением и голосовыми подсказками помогает найти нужный отдел, зал, стеллаж. Читатель говорит: «Покажи, как пройти к отделу краеведения», система строит маршрут и даёт голосовые инструкции.
Помощь читателям с нарушением слуха
Автоматические субтитры: мультимодальный ИИ генерирует субтитры к видео лекций, презентаций, онлайн-консультаций библиотекарей. Система распознаёт речь, расставляет знаки препинания, разделяет реплики разных спикеров.
Перевод речи в текст на мероприятиях: на лекции или экскурсии система в реальном времени преобразует речь ведущего в текст, который отображается на экране или в приложении на смартфоне читателя.
Адаптация интерфейса под потребности
Мультимодальный интерфейс даёт читателю выбор: задать вопрос текстом, голосом или показать изображение. Система отвечает в том формате, который удобен пользователю: текстом, голосом, визуально.
Пример: читатель с моторными нарушениями может искать книгу голосом вместо набора текста на клавиатуре. Незрячий читатель получает ответ голосом. Читатель с нарушением слуха видит текстовый ответ на экране.
Автоматическое описание иллюстраций и обложек
Библиотеки создают электронные коллекции книг, журналов, архивных материалов. Каждое изображение требует описания для доступности и поиска. Вручную описать тысячи иллюстраций — многомесячная работа. Мультимодальный ИИ справляется за часы.
Генерация alt-текста для иллюстраций
Alt-текст — текстовое описание изображения, которое читают скринридеры для незрячих пользователей. Vision-Language модель анализирует иллюстрацию и генерирует описание.
Алгоритм:
- Модель получает изображение иллюстрации из книги
- Анализирует содержимое: объекты, людей, действия, обстановку
- Генерирует описание текстом: «Женщина в красном платье сидит за столом и читает письмо. На столе — свеча и чашка»
- Библиотекарь проверяет описание, корректирует при необходимости
- Описание сохраняется как alt-текст к изображению
Точность: для чётких иллюстраций точность описания выше 90%. Модель называет объекты, цвета, расположение элементов, действия людей. Сложнее с абстрактными иллюстрациями, символикой, старинными гравюрами — там точность ниже, требуется редактура.
Описание обложек для каталога
Мультимодальный ИИ анализирует обложку книги и извлекает метаданные: название, автора, издательство, год издания. Это ускоряет каталогизацию новых поступлений.
Что извлекает ИИ с обложки:
- Название книги
- Имя автора
- Издательство и город издания
- Год издания
- ISBN (распознавание штрих-кода)
- Серия, если указана
Система проверяет извлечённые данные по внешним базам (РГБ, WorldCat), предлагает библиотекарю готовую карточку для подтверждения. Это сокращает время на каталогизацию одной книги с 10–15 минут до 2–3 минут.
Визуальный поиск по изображению
Читатель фотографирует обложку книги или иллюстрацию из неё, загружает фото в поиск по каталогу. Система распознаёт изображение, сопоставляет с обложками в базе, находит книгу и показывает карточку.
Сценарий: читатель увидел книгу у знакомого, не запомнил название, но сфотографировал обложку. Загружает фото в мобильное приложение библиотеки, система находит книгу в каталоге и показывает, есть ли она в наличии.
Голосовой и визуальный поиск по каталогу
Голосовой поиск
Читатель задаёт запрос голосом: «Найди книги Пушкина», «Покажи новинки по истории», «Где книга „Война и мир»?». Система распознаёт речь, выполняет поиск по каталогу, отвечает голосом или показывает результаты на экране.
Преимущества:
- Быстрее, чем набор текста на клавиатуре
- Доступно для читателей с моторными нарушениями
- Удобно на мобильных устройствах
- Работает на 20+ языках
Как это работает: читатель нажимает кнопку микрофона в поисковой строке каталога, произносит запрос. STT-модель распознаёт речь в текст, система выполняет поиск, показывает результаты. Если читатель запросил голосовой ответ, TTS-модель озвучивает результат: «Найдено 12 книг Пушкина. Первая — „Евгений Онегин», доступна в отделе художественной литературы».
Поиск по содержимому изображений
Читатель ищет книгу по описанию иллюстрации: «книга с картой сокровищ на обложке», «книга про космос с фотографией Земли». Система находит книги, у которых в описании обложки или иллюстраций есть совпадения.
Как это работает: все обложки и иллюстрации в каталоге описаны Vision-Language моделью. Описания индексируются как текст. Когда читатель вводит запрос, система ищет совпадения в описаниях изображений и показывает книги.
Пример: запрос «книга с рыжим котом на обложке» → система находит книги, в описании обложки которых есть слова «кот», «рыжий», «оранжевый».
Обработка оцифрованных архивов
Библиотеки оцифровывают архивы: старые газеты, рукописи, письма, дневники, карты. Мультимодальный ИИ распознаёт текст на сканах, описывает исторические фотографии, извлекает структурированные данные из плохо читаемых документов.
Распознавание рукописного текста (HTR)
Handwritten Text Recognition (HTR) — распознавание рукописного текста на сканах документов. Модель обучена на исторических почерках, распознаёт старинную орфографию, дореволюционный шрифт, выцветшие чернила.
Алгоритм обработки:
- Скан страницы загружается в систему
- Модель определяет строки текста, сегментирует их
- Распознаёт каждое слово, учитывает контекст предложения
- Генерирует текстовую версию страницы
- Библиотекарь проверяет результат, исправляет ошибки
Точность: для чётких рукописей точность распознавания 85–95%. Для выцветших, повреждённых документов точность ниже, но ИИ всё равно распознаёт большую часть текста, что сокращает ручную работу в десятки раз.
Описание исторических фотографий
Vision-Language модель описывает фотографии из архива: люди, места, события, предметы, одежда, обстановка. Описание становится метаданными для поиска.
Пример: фотография 1950-х годов. Модель генерирует описание: «Группа студентов в читальном зале библиотеки. За столом сидят четыре человека, перед ними раскрыты книги. На заднем плане — стеллажи с книгами и настольные лампы. Одежда студентов — рубашки, галстуки, характерные для 1950-х годов».
Это описание индексируется, по нему можно искать фотографии: «студенты в читальном зале», «библиотека 1950-е», «настольные лампы».
Извлечение данных из таблиц и форм
Архивные документы часто содержат таблицы: каталоги, реестры, формуляры читателей, инвентарные описи. Мультимодальный ИИ распознаёт структуру таблицы и извлекает данные в CSV или Excel.
Пример: скан формуляра библиотеки 1970-х годов. Система распознаёт столбцы (фамилия, имя, дата выдачи, название книги, дата возврата), извлекает данные, сохраняет в табличный файл для дальнейшего анализа.
Какие модели использовать
Vision-Language модели
| Модель | Разработчик | Применение в библиотеке |
|---|---|---|
| GPT-4 Vision | OpenAI | Описание иллюстраций, ответы на вопросы по изображениям |
| Claude 3.5 Sonnet | Anthropic | Анализ сложных схем, распознавание текста на изображениях |
| Gemini Pro Vision | Описание обложек, визуальный поиск, работа с видео | |
| LLaVA | Open-source | Описание изображений, развёртывание на собственных серверах |
Модели распознавания речи (STT)
| Модель | Разработчик | Применение в библиотеке |
|---|---|---|
| Whisper | OpenAI | Распознавание речи читателей, субтитры к видео |
| Google Speech-to-Text | Google Cloud | Голосовой поиск по каталогу, многоязычная поддержка |
| Azure Speech | Microsoft | Распознавание речи с высокой точностью, кастомизация |
| Vosk | Open-source | Распознавание речи офлайн, работа без интернета |
Модели синтеза речи (TTS)
| Модель | Разработчик | Применение в библиотеке |
|---|---|---|
| Google Text-to-Speech | Google Cloud | Озвучка ответов чат-бота, аудиокниги |
| Azure Neural TTS | Microsoft | Высококачественный синтез речи, естественные интонации |
| Amazon Polly | AWS | Озвучка текстов, голосовые уведомления |
| Silero TTS | Open-source | Синтез русской речи, работа офлайн |
OCR для распознавания текста на изображениях
| Модель | Разработчик | Применение в библиотеке |
|---|---|---|
| Tesseract OCR | Open-source | Распознавание печатного текста, бесплатное решение |
| Azure AI Vision | Microsoft | Распознавание текста, рукописей, извлечение данных из форм |
| Google Cloud Vision | Распознавание текста, меток, объектов на изображениях | |
| EasyOCR | Open-source | Распознавание текста на 80+ языках |
Как внедрить мультимодальный ИИ
Шаг 1. Определить приоритетную задачу
Начните с одной задачи, где мультимодальный ИИ даёт быстрый результат. Варианты для старта:
- Автоматическое описание обложек новых поступлений
- Голосовой поиск по каталогу в мобильном приложении
- Распознавание рукописей в небольшой коллекции архивных документов
- Генерация alt-текста для иллюстраций в электронной библиотеке
Шаг 2. Выбрать модель
Для пилотного проекта подходят облачные API: GPT-4 Vision, Gemini Pro Vision, Azure AI Vision. Стоимость — от 0.01$ до 0.05$ за изображение в зависимости от провайдера и объёма запросов. Для голосового интерфейса — Whisper (STT) и Google Text-to-Speech (TTS).
Если нужна работа без интернета или на собственных серверах — используйте open-source модели: LLaVA для vision-language, Vosk для STT, Silero для TTS. Потребуется сервер с GPU (например, NVIDIA RTX 4090 или облачный GPU-инстанс).
Шаг 3. Подготовить тестовый датасет
Соберите 50–100 изображений для проверки: обложки книг, иллюстрации, сканы документов. Прогоните через модель, проверьте качество описаний. Если точность ниже 80% — уточните промпт для модели или выберите другую модель.
Пример промпта для описания обложки: «Опиши обложку книги. Укажи название, автора, издательство, год издания, если они видны. Опиши визуальное оформление: цвета, изображения, шрифты.»
Шаг 4. Интегрировать с каталогом
Подключите API модели к системе каталогизации или поиска. Для описания обложек — автоматический вызов модели при загрузке изображения новой книги. Для голосового поиска — кнопка микрофона в поисковой строке каталога.
Технический стек:
- Backend: Python + FastAPI для обработки запросов
- Интеграция с Vision API: библиотека openai, google-cloud-vision или anthropic
- Интеграция с STT/TTS: библиотека openai-whisper, google-cloud-speech
- Frontend: кнопка загрузки изображения или записи голоса в интерфейсе каталога
Шаг 5. Добавить проверку библиотекарем
Автоматически сгенерированные описания должны проверяться человеком перед публикацией. Создайте интерфейс, где библиотекарь видит изображение, описание от ИИ и может отредактировать текст перед сохранением.
Это критично для описаний исторических документов, редких книг, архивных фотографий — там важна точность деталей, которую ИИ не всегда гарантирует.
Шаг 6. Масштабировать на всю коллекцию
Когда пилот показал результат, масштабируйте на всю коллекцию. Для обработки 10 000 изображений потребуется несколько дней работы системы и 500–1000$ на API (зависит от модели и объёма). Это в десятки раз дешевле ручной работы и в сотни раз быстрее.
Чек-лист внедрения мультимодального ИИ
- Определена приоритетная задача (описание обложек, голосовой поиск, распознавание рукописей)
- Выбран провайдер и модель (облачный API или open-source)
- Подготовлен тестовый датасет из 50–100 изображений
- Проверено качество работы модели на тестовых данных
- Настроены промпты для получения нужного формата описаний
- Реализована интеграция с каталогом или системой управления контентом
- Добавлен интерфейс проверки результатов библиотекарем
- Проведён пилот на ограниченной выборке (100–500 единиц)
- Собрана обратная связь от сотрудников и читателей
- Масштабирование на полную коллекцию запланировано и бюджетировано
Что почитать
- LAVIS: A Library for Language-Vision Intelligence — open-source библиотека для работы с vision-language моделями
- IFLA WLIC 2026: Practical Implementations of AI in Public Libraries — материалы конференции о практическом применении ИИ в библиотеках
- Digital Accessibility Trends for 2026 — обзор трендов цифровой доступности с акцентом на мультимодальный ИИ
- Accessibility Trends to Watch in 2026 — как мультимодальные интерфейсы улучшают доступность контента
Частые вопросы
Чем мультимодальный ИИ отличается от обычного чат-бота?
Обычный чат-бот работает только с текстом. Мультимодальный ИИ понимает изображения, видео, голос и текст одновременно. Читатель может сфотографировать обложку книги и получить информацию о ней, задать вопрос голосом или показать рукописный текст для распознавания.
Какие мультимодальные модели подходят для библиотеки?
Для описания изображений — GPT-4 Vision, Claude 3.5 Sonnet, Gemini Pro Vision. Для распознавания текста на фото — Tesseract OCR, Azure AI Vision. Для преобразования речи в текст — Whisper от OpenAI, Google Speech-to-Text. Часто используют несколько моделей в связке для разных задач.
Насколько точно мультимодальный ИИ описывает иллюстрации в книгах?
Точность зависит от качества изображения и модели. Для чётких иллюстраций точность описания выше 90%. Модель называет объекты, людей, действия, цвета, расположение элементов. Сложнее с абстрактными иллюстрациями и символикой. Описания всегда проверяет библиотекарь перед публикацией.
Можно ли использовать мультимодальный ИИ для оцифрованных архивов?
Да. ИИ распознаёт рукописный текст на сканах документов, описывает исторические фотографии, извлекает текст из плохо читаемых страниц. Это ускоряет обработку архивов в десятки раз. Подходит для писем, дневников, газет, карт, чертежей.
Нужна помощь с внедрением мультимодального ИИ?
Подпишитесь на нашу рассылку — делимся кейсами внедрения, обзорами инструментов и готовыми решениями для библиотек. Один раз в месяц, без спама.